


 nueva página del texto (beta)
 Español (pdf)
 Artículo en XML
 Referencias del artículo

 Traducción automática
 Enviar artículo por email
 Citado por SciELO
 Similares en
SciELO

 Permalink


Introducción
En años recientes se han dado grandes avances en la tecnología como los dispositivos móviles, internet y redes de telefonía móvil, lo cual impacta en diversas áreas. Una de las áreas que ha recibido una gran influencia debido al desarrollo tecnológico es la educación. El crecimiento en las tecnologías de la información y la comunicación ha facilitado las actividades de aprendizaje en la adquisición de conocimientos y además, en la recopilación de registros de usuarios. En instituciones educativas, las herramientas digitales han permitido mejorar los métodos de acceso y almacenamiento de información de estudiantes tales como calificaciones, asistencia, créditos cursados entre muchos otros atributos (Salas et al., 2019). El procesamiento y análisis de información permite entender los datos para dar posibles soluciones a problemas en el área educativa que pueden influir en los procesos de enseñanza y aprendizaje. Dichos análisis permiten identificar ciertas similitudes, diferencias y patrones en los datos que pueden ayudar al desarrollo de políticas educativas y a mejorar las prácticas pedagógicas (Zambrano et al., 2024). De entre los análisis de registros educativos empleados en la mejora de los procesos de enseñanza se encuentra la predicción del rendimiento académico de estudiantes mediante las técnicas de aprendizaje automático (Del Carpio, 2024).
La predicción del rendimiento académico de estudiantes universitarios ha aumentado debido al interés de investigadores e instituciones educativas en mejorar la estrategia pedagógica e identificar tempranamente a estudiantes en peligro de reprobación que requieren algún tipo de apoyo o intervención académica (Zambrano et al., 2024). Para realizar la predicción del rendimiento académico se han empleado técnicas de aprendizaje automático (Vargas y Prieto, 2024). Estas técnicas permiten construir modelos de predicción a partir de un conjunto de registros llamados datos de entrenamiento con el objetivo de predecir y validar con otro conjunto de datos conocido como datos de prueba. Existen trabajos en esta línea de investigación, como el realizado en (Gil y Quintero, 2023), en el cual los autores utilizan datos de estudiantes que participaron en cuatro cursos universitarios virtuales. Los autores construyeron modelos de predicción con diferentes técnicas de aprendizaje automático a partir de siete variables académicas predictoras. Villarrasa et al. (2024) realizaron modelos de predicción del rendimiento académico realizando una técnica de aprendizaje automático conocida como árbol de decisión empleando 14 variables predictoras.
Actualmente, existen trabajos que emplean modelos predictivos del rendimiento académico desarrollados con técnicas de aprendizaje automático combinadas (Contreras et al., 2021), es decir, combinan técnicas como si fuera una sola con el propósito de mejorar las predicciones. En México existe poco avance en el desarrollo de modelos predictivos con este tipo de técnicas debido, entre otras causas, a la falta de conocimiento de dichas metodologías. Esto ha ocasionado un cierto retraso en comparación con otros países en cuanto al procesamiento de datos académicos con el potencial beneficio de mejora de la enseñanza. Por lo anterior, en esta investigación se plantean las siguientes preguntas de investigación: ¿Cómo elaborar modelos predictivos del rendimiento académico de estudiantes en México utilizando ejercicios realizados en clase y empleando técnicas de aprendizaje automático combinadas? ¿De qué manera evaluar los modelos predictivos desarrollados? De esta manera, el objetivo de este artículo es elaborar una metodología para construir modelos predictivos del rendimiento académico de estudiantes de México al finalizar un curso mediante ejercicios realizados en clase con técnicas de aprendizaje automático combinadas y proponer métricas para evaluar dichos modelos.
Metodología
La metodología empleada en la presente investigación consiste en recabar información de 250 estudiantes de una universidad pública en México acerca de sus evaluaciones obtenidas en cinco ejercicios académicos de una asignatura de Matemáticas en las primeras semanas. Con esta información se realizan modelos de predicción de la aprobación o reprobación de la asignatura, es decir, de su desempeño académico al final del curso. Este tipo de herramientas facilita a los profesores identificar a los estudiantes con mayor probabilidad de que reprueben el curso, y en consecuencia, realizar intervenciones que permitan regularizar a estos estudiantes en etapas tempranas del curso. En la Figura 1 se presenta de manera esquemática la metodología utilizada.
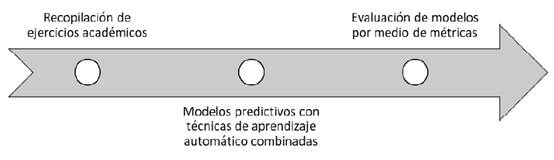
Los ejercicios se realizaron en las tres primeras semanas del curso, cuya duración es de 18 semanas. Se informó a los participantes que los datos recabados se utilizarían únicamente con fines de investigación educativa. Además, para proteger la confidencialidad y por razones éticas no se utilizaron sus nombres, sino que se les asoció un número identificador ya que las técnicas de aprendizaje automático no los requieren.
En este estudio, las evaluaciones de los ejercicios tuvieron un rango de calificación de 0 a 10. Se clasificaron como aquellas que son aprobatorias, es decir, son igual o más de seis (≥ 6), las que fueron reprobatorias o menor a seis (< 6) y los ejercicios que no fueron entregados por los estudiantes para su evaluación (sin entregar). Finalmente, la evaluación final del curso de cada estudiante tiene los valores de aprobado o reprobado. Parte de la estructura de los datos recabados de los estudiantes se presenta en la tabla 1.
Tabla 1 Estructura de datos recabados en la investigación.
| Registro 1 | Registro 2 | ….. | Registro 250 | |
|---|---|---|---|---|
| Ejercicio 1 | < 6 | sin entregar | ….. | < 6 |
| Ejercicio 2 | ≥ 6 | ≥ 6 | ….. | Sin entregar |
| Ejercicio 3 | < 6 | ≥ 6 | ….. | ≥ 6 |
| Ejercicio 4 | ≥ 6 | sin entregar | ….. | ≥ 6 |
| Ejercicio 5 | < 6 | sin entregar | ….. | ≥ 6 |
| Evaluación final del curso | aprobado | reprobado | ….. | aprobado |
Fuente: Elaboración propia
En la realización de los modelos predictivos se emplearon técnicas de aprendizaje automático combinadas, específicamente, las técnicas de voto mayoritario y de apilamiento.
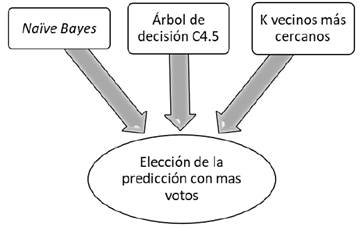
La técnica de voto mayoritario consiste en utilizar las predicciones de técnicas base de aprendizaje automático, posteriormente, elige la predicción que tenga la mayor cantidad de votos, es decir, la de voto mayoritario (García et al., 2023). Las técnicas base empleadas para esta investigación son Naïve Bayes (Sarmiento et al., 2024), árbol de decisión C4.5 (Timarán et al., 2023) y k vecinos más cercanos (Arengas et al., 2024). La estructura de la técnica voto mayoritario que se realizó en este artículo se representa en la Figura 2.
Fuente: Elaboración propia
Figura 2 Estructura de la técnica voto mayoritario en los modelos predictivos.
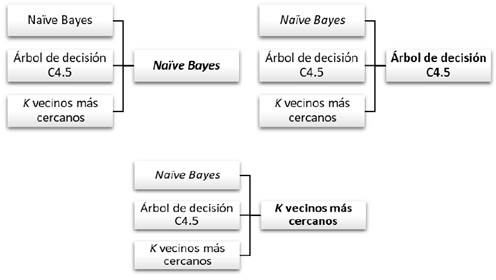
La técnica de apilamiento o stacking es un algoritmo de aprendizaje automático que emplea las predicciones de técnicas base (primera fase) como entradas a otra técnica de aprendizaje automático (segunda fase) (Cruz, 2024). En la primera fase se utilizan las tres técnicas de aprendizaje automático que las empleadas en voto mayoritario, y en la segunda fase, se utilizan las mismas tres técnicas de la primera fase obteniendo tres técnicas de apilamiento diferentes como se muestra en la Figura 3.
Fuente: Elaboración propia
Figura 3 Estructura de las técnicas de apilamiento en los modelos predictivos.
Estos modelos y todos los análisis en este artículo se hicieron con el apoyo del software libre conocido como Weka (Nizar et al., 2024). Asimismo, requieren ser evaluados, es decir, necesitan de métricas para verificar que las predicciones dadas sean aceptables. Las métricas que se emplean en esta investigación son la exactitud, la tasa de verdaderos positivos y la tasa de verdaderos negativos (Yajure, 2023; Daza et al., 2024). La exactitud de las predicciones es aquella que contabiliza las predicciones que fueron acertadas dividido entre el total de las predicciones realizadas por el modelo. La tasa de verdaderos positivos son las predicciones de aprobación del estudiante dividido entre todas las predicciones de aprobación reales. La tasa de verdaderos negativos es la misma relación pero considerando las predicciones de reprobación del estudiante. Para cada técnica de aprendizaje automático, estas métricas se calculan utilizando la validación cruzada considerando 10 grupos (Sierra et al., 2024) de manera parecida a como ha sido empleada en trabajos similares en la literatura (Parraga, 2024). Este método consiste en dividir los datos aleatoriamente en 10 grupos, se utilizan 9 grupos para construir el modelo y se hacen predicciones del grupo restante, este proceso se repite en 10 ocasiones. La exactitud, la tasa de verdaderos positivos y la tasa de verdaderos negativos son el promedio de las obtenidas en el proceso de validación cruzada para cada una de las técnicas de aprendizaje automático usadas en esta investigación. En el caso específico de la técnica de k vecinos más cercanos que se utiliza como técnica base para la técnica de voto mayoritario y las de apilamiento, así como la que se emplea en la segunda fase de la técnica de apilamiento, se seleccionó el parámetro k que maximice la exactitud de las predicciones en su respectiva validación cruzada. En la siguiente sección se muestran los resultados de estas métricas con las técnicas de aprendizaje automático.
Resultados
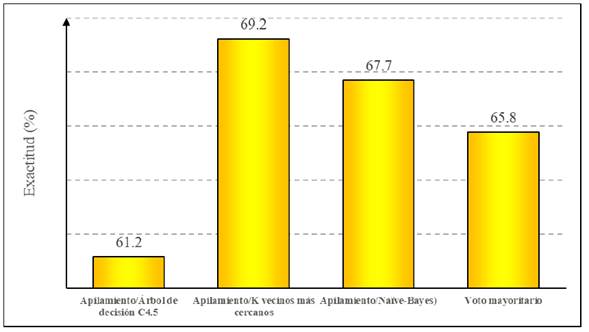
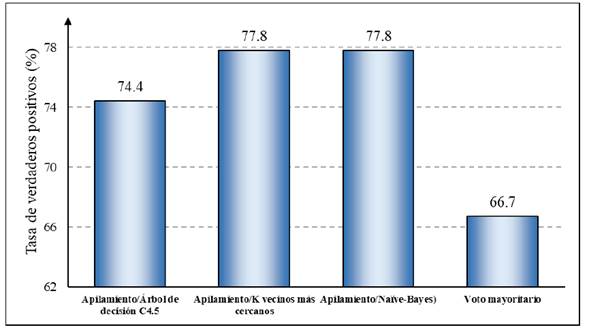
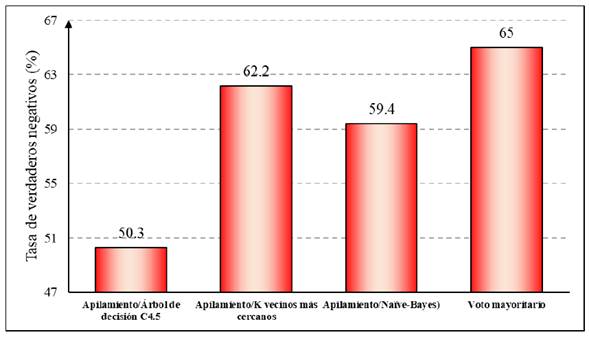
En los resultados de esta sección se emplean los modelos predictivos realizados con técnicas de aprendizaje automático combinadas que incluyen voto mayoritario y tres técnicas de apilamiento descritas en la sección anterior. En las Figuras 4, 5 y 6 se presentan la exactitud, la tasa de verdaderos positivos y la tasa de verdaderos negativos con la técnica de voto mayoritario (Figura 2) y las tres técnicas de apilamiento (Figura 3). En el caso de las técnicas de apilamiento, para distinguir la técnica de que se utiliza en la segunda fase, se propone representar como “apilamiento/técnica en la segunda fase”, por ejemplo, “apilamiento / Naïve Bayes” significa que se utiliza la técnica de apilamiento teniendo en la segunda fase el algoritmo Naïve Bayes.
Fuente: Elaboración propia
Figura 4 Exactitud de los modelos predictivos del rendimiento académico con las técnicas de aprendizaje automático combinadas utilizando validación cruzada.
En la Figura 4 se observa que la técnica de Apilamiento/K vecinos más cercanos es la que consigue la exactitud mayor en comparación con las demás, la cual es de 69.2%. También se puede apreciar que la técnica Apilamiento/Árbol de decisión C4.5 es inferior a las demás (61.2%).
Fuente: Elaboración propia
Figura 5 Tasa de verdaderos positivos de los modelos predictivos del rendimiento académico con las técnicas de aprendizaje automático combinadas utilizando validación cruzada.
Las tasas de verdaderos positivos con las técnicas de apilamiento son las más altas como se muestra en la Figura 5, específicamente las que utilizan Naïve Bayes y k vecinos más cercanos en la segunda fase. Además, se observa que la tasa de verdaderos positivos con la técnica de voto mayoritario es mucho menor que las demás.
Fuente: Elaboración propia
Figura 6 Tasa de verdaderos negativos de los modelos predictivos del rendimiento académico con las técnicas de aprendizaje automático combinadas utilizando validación cruzada.
En la Figura 6, la tasa de verdaderos negativos con la técnica de voto mayoritario (65%) es la mayor en comparación a las demás técnicas de apilamiento.
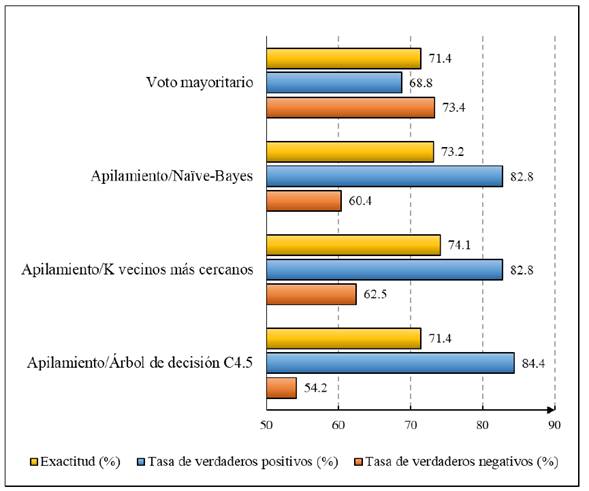
Para mostrar la utilidad de los modelos desarrollados con las técnicas de aprendizaje automático combinadas se realiza la predicción de 108 estudiantes universitarios del mismo curso pero de un periodo de impartición posterior, es decir, es una muestra independiente. Al terminar, se recopiló la información referente a su aprobación para comparar con las predicciones de los modelos con lo cual se obtuvieron las métricas de exactitud, tasa de verdaderos positivos y tasa de verdaderos negativos, las cuales se muestran en la Figura 7.
Fuente: Elaboración propia
Figura 7 Métricas de los modelos predictivos del rendimiento académico con las técnicas de aprendizaje automático combinadas.
En la figura anterior se observa que la tasa de verdaderos positivos tiende a ser mayor en los modelos en comparación con las demás métricas con valores, de forma análoga, la tasa de verdaderos negativos muestra una tendencia a ser menor. Además, la exactitud de las predicciones tiende a ser similar con todas las técnicas, siendo mayor con la técnica de apilamiento que utiliza k vecinos más cercanos en la segunda fase (alrededor de 70%).
Discusión
Los resultados obtenidos con validación cruzada muestran que la técnica de apilamiento que tiene en la segunda fase el algoritmo k vecinos tiene una mayor exactitud (69.2%), las que tienen Naïve Bayes y k vecinos más cercanos tienen la más alta tasa de verdaderos positivos (77.8%) y la técnica de voto mayoritario es la que tiene el valor mayor de tasa de verdaderos negativos (65%). De esta manera, con los datos utilizados, no se tiene una técnica, de las empleadas en esta investigación, que obtenga los mejores valores de las métricas en todos los casos, sino que es necesario elegir la técnica más adecuada de acuerdo con la métrica que se quiera con mayor valor. En este sentido, cuando se predice el rendimiento académico con otro grupo de datos (108 estudiantes) a partir de los modelos desarrollados, la exactitud más alta se obtiene con la técnica de apilamiento que tiene en la segunda fase la técnica k vecinos más cercanos con un valor de 74.1%. La tasa de verdaderos positivos más alta se obtuvo de 84.4% con la técnica de apilamiento con árbol de decisión C4.5. y la tasa de verdaderos negativos mayor se calculó de 73.4% con la técnica de voto mayoritario.
En la investigación realizada los ejercicios se elaboraron en las primeras tres semanas de un total de 18 semanas que dura el curso, es decir, las predicciones se realizaron cuando el curso había avanzado un 17%, lo que permite identificar de manera temprana los estudiantes que tienen altas probabilidades de reprobar el curso para que los profesores puedan realizar intervenciones pedagógicas específicas. También, es importante tener en cuenta que la recopilación de las evaluaciones de los ejercicios académicos es habitual en los profesores sin requerir utilizar otras herramientas más complejas de recopilación de información lo que hace más accesible utilizar este tipo de metodologías para construir modelos predictivos.
Existen trabajos que utilizan métricas para evaluar los modelos predictivos similares a las empleadas en la presente investigación. En el estudio realizado por Gil y Quintero (2023) consiguieron una exactitud máxima en sus modelos de 59% y una tasa de verdaderos positivos con un valor máximo de 71%. Para ello, emplearon siete atributos o variables para realizar los modelos de predicción y los datos recabados los partieron en 70% para entrenamiento y 30% para prueba. Villarrasa et al. (2024) obtuvieron los valores máximos de exactitud, tasa de verdaderos positivos y tasa de verdaderos negativos de 81.4%, 79% y 83.33% respectivamente. Emplearon 14 variables y dividieron los datos en 80% de entrenamiento y 20% para prueba. En contraste con estos trabajos, en el presente estudio se utilizó la validación cruzada agregando aleatoriedad a los experimentos ofreciendo resultados potencialmente más robustos de las métricas. Además, los datos de prueba fueron estudiantes a predecir su rendimiento en el curso al momento de realizar el estudio en lugar de registros almacenados con anterioridad. En esta investigación se requirieron cinco variables predictoras y se obtuvieron valores de las métricas superiores a los obtenidos por Gil y Quintero (2023). Si bien las métricas obtenidas en Villarrasa et al. (2024) son mayores a los obtenidos en la presente investigación, el número de variables empleadas en el presente artículo es mucho menor. También, se debe notar que los trabajos anteriores emplean variables que su recopilación no es tan fácil de obtener por los profesores, a diferencia de este trabajo, donde las evaluaciones de los ejercicios son recopiladas por los profesores de manera habitual.
Por último, la metodología desarrollada en este estudio podría emplearse en otros cursos y modalidades educativas con el propósito de detectar estudiantes con dificultades académicas y el profesor pueda implementar estrategias de apoyo adecuadas para mejorar su rendimiento.
Conclusiones
En este trabajo se diseñó una metodología en la que se desarrollaron modelos de predicción del desempeño académico al terminar un curso de estudiantes de México empleando ejercicios hechos en clase y técnicas de aprendizaje automático combinadas. Éstas fueron voto mayoritario y tres técnicas de apilamiento. Para evaluar los modelos se utilizaron las métricas de exactitud, tasa de verdaderos positivos y tasa de verdaderos negativos. Estas métricas se obtuvieron, primeramente, con el método de validación cruzada, y posteriormente, aplicando los modelos realizados con otro conjunto de datos, esto es, con datos de prueba.
Cuando se evaluaron los modelos con validación cruzada los valores más altos de exactitud (69.2%), tasa de verdaderos positivos (77.8%) y tasa de verdaderos negativos (65%) se obtuvieron con la técnica de apilamiento que en la segunda fase tiene el algoritmo k vecinos más cercanos, con las de apilamiento que tienen Naïve Bayes y k vecinos más cercanos, y con la de voto mayoritario, respectivamente.
Cuando se evaluaron los modelos con los datos de prueba los valores más altos de exactitud (74.1%), tasa de verdaderos positivos (84.4%) y tasa de verdaderos negativos (73.4%) resultaron con la técnica de apilamiento que tiene en la segunda fase la técnica k vecinos más cercanos, con la técnica de apilamiento con árbol de decisión C4.5 y con la técnica de voto mayoritario, respectivamente.
La información recabada de los estudiantes se llevó a cabo en las primeras tres semanas del curso, equivalente a un 17% de avance en la asignatura. Esto facilita detectar de manera temprana a los estudiantes que puedan tener dificultades escolares y que los profesores brinden intervenciones oportunas para mejorar su rendimiento. Este tipo de metodologías podría ser replicada en otros cursos y niveles educativos. Además, permite entender las necesidades específicas de estudiantes para personalizar programas de asesorías o de otro tipo de estrategias de apoyo dependiendo de la asignatura. Los modelos predictivos pueden contribuir a hacer uso más eficiente de recursos de la institución educativa lo que permite enfocar en estudiantes que más lo requieran.
Se debe notar que, a pesar de los avances mostrados en la presente investigación, existen varias líneas de mejora sobre la temática tratada en este estudio. Entre las cuales se incluyen emplear la metodología con otro tipo de técnicas de aprendizaje automático o con otras características de estudiantes con el fin de mejorar las métricas de evaluación.
Futuras líneas de investigación
Cabe mencionar que, a pesar de los progresos conseguidos en el presente artículo, se limitó al contexto institucional, al tamaño de muestra, al tipo y cantidad de variables. No obstante, es posible continuar profundizando sobre esta línea de investigación. Se considera pertinente incrementar la cantidad de datos empleados en cada modelo. Además, puede ser de interés, incrementar el número de técnicas de aprendizaje automático que se emplean en la técnica de voto mayoritario y en la de apilamiento. Asimismo, se puede emplear otro tipo de atributos (académicos, sociales, conductuales, etc.) que puedan influir en el desempeño académico del estudiante.

