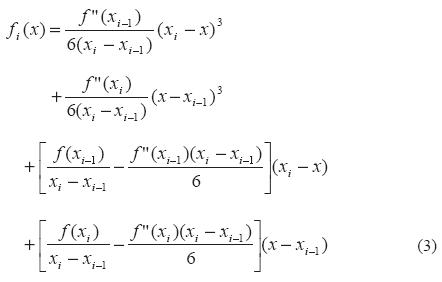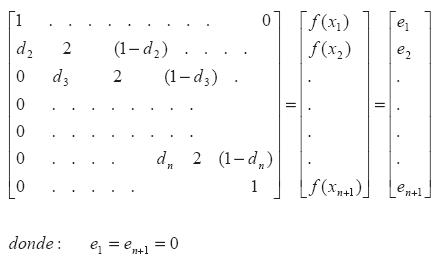<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>1405-7425</journal-id>
<journal-title><![CDATA[Papeles de población]]></journal-title>
<abbrev-journal-title><![CDATA[Pap. poblac]]></abbrev-journal-title>
<issn>1405-7425</issn>
<publisher>
<publisher-name><![CDATA[Universidad Autónoma del Estado de México, Centro de Investigación y Estudios Avanzados de la Población]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S1405-74252011000300003</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[La obtención y proyección de tablas de mortalidad empleando curvas spline]]></article-title>
<article-title xml:lang="en"><![CDATA[Obtaining and projection of mortality tables using spline curves]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Mina-Valdés]]></surname>
<given-names><![CDATA[Alejandro]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,Colegio de México Centro de Estudios Demográficos Urbanos y Ambientales ]]></institution>
<addr-line><![CDATA[ ]]></addr-line>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>09</month>
<year>2011</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>09</month>
<year>2011</year>
</pub-date>
<volume>17</volume>
<numero>69</numero>
<fpage>49</fpage>
<lpage>72</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://www.scielo.org.mx/scielo.php?script=sci_arttext&amp;pid=S1405-74252011000300003&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://www.scielo.org.mx/scielo.php?script=sci_abstract&amp;pid=S1405-74252011000300003&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://www.scielo.org.mx/scielo.php?script=sci_pdf&amp;pid=S1405-74252011000300003&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="es"><p><![CDATA[Una de las herramientas del análisis numérico es el uso de polinomios de n-ésimo orden para interpolar entre n + 1 puntos, teniéndose casos en donde estas funciones polinómicas pueden llevar a resultados erróneos. Una alternativa es la de aplicar polinomios de orden inferior a subconjuntos de datos. Estos polinomios conectados se llaman funciones de interpolación segmentaria (spline functions). En este artículo se presenta la herramienta que el análisis numérico proporciona como instrumento técnico necesario para llevar a cabo todos los procedimientos matemáticos existentes con base a algoritmos que permitan su simulación o cálculo, en especial, las funciones splines definidas a trozos (por tramos), con interpolación mediante ellas, dando lugar a el ajuste de curvas spline con base en la serie de sobrevivientes lx de una tabla abreviada de mortalidad mexicana, con el fin de desagregarla por edad desplegada, respetando las concavidades que por el efecto de la mortalidad en las primeras edades y en las siguientes se tienen en la experiencia mexicana. También empleando las curvas splines se presentan las simulaciones que permiten obtener escenarios futuros de las series de sobrevivientes lx, que dan lugar a las proyecciones de la mortalidad mexicana para los años 2010-2050, las que generan las tablas completas de mortalidad para hombres y mujeres de dicho periodo, resaltando las diferencias entre sexos y edades de sus probabilidades de supervivencia y las ganancias en las esperanzas de vida.]]></p></abstract>
<abstract abstract-type="short" xml:lang="en"><p><![CDATA[One of the tools of numerical analysis is the use of polynomials of Nth order to interpolate between n+1 points, taking cases where these polynomial functions can lead to erroneous results. An alternative is to implement polynomials of lesser order than the subsets of data. These connected polynomials are called functions of segmental interpolation (spline functions). This article introduces the tool provided by numerical analysis as a technical instrument needed to carry out all existing mathematical procedures based on algorithms to enable its simulation or calculation, in particular, the functions spline defined in ranges (by sections), with interpolation through them, giving rise to the adjustment of spline curves based on surviving an abbreviated table of Mexican mortality lx series in order to disaggregate by age deployed, respecting the cavities that because of the effect of mortality in the early and following ages appear in the Mexican experience. Also using splines the simulations that allow obtaining future scenarios of the surviving lx series produces the Mexican mortality for the years 2010-2050, projections that generate complete tables of mortality for men and women of this period, highlighting the differences between sexes and ages of their chances to survive and increments in life expectancy.]]></p></abstract>
<kwd-group>
<kwd lng="es"><![CDATA[interpolación polinómica]]></kwd>
<kwd lng="en"><![CDATA[splines]]></kwd>
<kwd lng="es"><![CDATA[tablas de mortalidad]]></kwd>
<kwd lng="en"><![CDATA[polynomial interpolation]]></kwd>
<kwd lng="en"><![CDATA[splines]]></kwd>
<kwd lng="en"><![CDATA[tables of mortality]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[ <p align="center"><font face="verdana" size="4"><b>La obtenci&oacute;n y proyecci&oacute;n de tablas de mortalidad empleando curvas <i>spline</i></b></font></p>     <p align="center"><font face="verdana" size="2">&nbsp;</font></p>     <p align="center"><font face="verdana" size="3"><b>Obtaining and projection of mortality tables using spline curves</b></font></p>     <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="center"><font face="verdana" size="2"><b>Alejandro Mina&#45;Vald&eacute;s</b></font></p>     <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><i>El Colegio de M&eacute;xico</i></font>.</p>     <p align="justify">&nbsp;</p>     <p align="justify"><font size="2" face="verdana">Recibido: el 16 de junio de 2011     <br>   Aprobado: el 27 de septiembre de 2011.</font></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><b>Resumen</b></font></p>     <p align="justify"><font face="verdana" size="2">Una de las herramientas del an&aacute;lisis num&eacute;rico es el uso de polinomios de n&#45;&eacute;simo orden para interpolar entre n + 1 puntos, teni&eacute;ndose casos en donde estas funciones polin&oacute;micas pueden llevar a resultados err&oacute;neos. Una alternativa es la de aplicar polinomios de orden inferior a subconjuntos de datos. Estos polinomios conectados se llaman funciones de interpolaci&oacute;n segmentaria <i>(spline functions). </i>En este art&iacute;culo se presenta la herramienta que el an&aacute;lisis num&eacute;rico proporciona como instrumento t&eacute;cnico necesario para llevar a cabo todos los procedimientos matem&aacute;ticos existentes con base a algoritmos que permitan su simulaci&oacute;n o c&aacute;lculo, en especial, las funciones <i>splines </i>definidas a trozos (por tramos), con interpolaci&oacute;n mediante ellas, dando lugar a el ajuste de curvas spline con base en la serie de sobrevivientes <i>lx </i>de una tabla abreviada de mortalidad mexicana, con el fin de desagregarla por edad desplegada, respetando las concavidades que por el efecto de la mortalidad en las primeras edades y en las siguientes se tienen en la experiencia mexicana. Tambi&eacute;n empleando las curvas <i>splines </i>se presentan las simulaciones que permiten obtener escenarios futuros de las series de sobrevivientes <i>lx, </i>que dan lugar a las proyecciones de la mortalidad mexicana para los a&ntilde;os 2010&#45;2050, las que generan las tablas completas de mortalidad para hombres y mujeres de dicho periodo, resaltando las diferencias entre sexos y edades de sus probabilidades de supervivencia y las ganancias en las esperanzas de vida.</font></p>    <p align="justify"><font face="verdana" size="2"><b>Palabras clave:</b> interpolaci&oacute;n polin&oacute;mica, <i>splines, </i>tablas de mortalidad.</font></p>    <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><b>Abstract</b></font></p>     <p align="justify"><font face="verdana" size="2">One of the tools of numerical analysis is the use of polynomials of Nth order to interpolate between n+1 points, taking cases where these polynomial functions can lead to erroneous results. An alternative is to implement polynomials of lesser order than the subsets of data. These connected polynomials are called functions of segmental interpolation (spline functions). This article introduces the tool provided by numerical analysis as a technical instrument needed to carry out all existing mathematical procedures based on algorithms to enable its simulation or calculation, in particular, the functions spline defined in ranges (by sections), with interpolation through them, giving rise to the adjustment of spline curves based on surviving an abbreviated table of Mexican mortality lx series in order to disaggregate by age deployed, respecting the cavities that because of the effect of mortality in the early and following ages appear in the Mexican experience. Also using splines the simulations that allow obtaining future scenarios of the surviving lx series produces the Mexican mortality for the years 2010&#45;2050, projections that generate complete tables of mortality for men and women of this period, highlighting the differences between sexes and ages of their chances to survive and increments in life expectancy.</font></p>     <p align="justify"><font face="verdana" size="2"><b>Key words:</b> polynomial interpolation, splines, tables of mortality.</font></p>    <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>    <p align="justify"><font face="verdana" size="2"><b>Introducci&oacute;n</b></font></p>    ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">El an&aacute;lisis num&eacute;rico proporciona el instrumento t&eacute;cnico necesario para llevar a cabo todos los procedimientos matem&aacute;ticos existentes con base a algoritmos que permitan su simulaci&oacute;n o c&aacute;lculo. En el subcampo matem&aacute;tico del an&aacute;lisis num&eacute;rico, una curva <i>spline </i>es definida a trozos (por tramos) mediante polinomios, teni&eacute;ndose que en los problemas de interpolaci&oacute;n se utiliza a menudo la interpolaci&oacute;n mediante <i>splines </i>porque da lugar a resultados similares requiriendo solamente el uso de polinomios de bajo grado, con la ventaja de que se evitan las oscilaciones, que en la mayor&iacute;a de las aplicaciones resultan indeseables, las que aparecen al interpolar mediante polinomios de grado elevado, en general mayores a grado 3. El trabajo presenta el ajuste de curvas <i>spline </i>con base en la serie de sobrevivientes <i>lx </i>de una tabla abreviada de mortalidad mexicana, con el fin de desagregarla por edad desplegada, respetando las concavidades que por el efecto de la mortalidad en las primeras edades y en las siguientes se tienen en la experiencia mexicana.</font></p>    <p align="justify"><font face="verdana" size="2">Una ventaja del empleo de las curvas <i>spline </i>es la posibilidad de hacer simulaciones que permitan obtener escenarios futuros de las series de sobrevivientes <i>lx, </i>por ello tambi&eacute;n se obtendr&aacute;n mediante los ajustes <i>spline, </i>proyecciones de la mortalidad mexicana para los a&ntilde;os 2010&#45;2050, generando las tablas completas de mortalidad para hombres y mujeres de dicho periodo, lo que permitir&aacute; la cuantificaci&oacute;n de las ganancias en la esperanza de vida por edad y sexo en M&eacute;xico.</font></p>    <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><b>Interpolaci&oacute;n segmentaria</b></font></p>     <p align="justify"><font face="verdana" size="2">El concepto de interpolaci&oacute;n segmentaria se origin&oacute; de la t&eacute;cnica de uso de una l&aacute;mina de pl&aacute;stico delgada (llamada curv&iacute;grafo, en ingl&eacute;s <i>spline) </i>en el trazo de curvas suaves a trav&eacute;s de un conjunto de puntos. En esta t&eacute;cnica, el dibujante colocaba papel sobre un tablero de madera y clavaba tachuelas en el papel (y en el tablero) en la posici&oacute;n de los datos. Al pasar un hilo entre las tachuelas se describ&iacute;a una curva c&uacute;bica suave. De ah&iacute; que se haya adoptado el nombre de "interpelaci&oacute;n segmentaria" <i>(cubic spline) </i>para polinomios de este tipo.</font></p>    <p align="justify"><font face="verdana" size="2">En el an&aacute;lisis num&eacute;rico es posible usar polinomios de n&#45;&eacute;simo orden para interpolar entre n + 1 puntos. Por ejemplo, en ocho puntos, se deriva un polinomio perfecto de s&eacute;ptimo orden. Esta curva captura todos los serpenteos (al menos considera hasta derivadas de s&eacute;ptimo orden) sugeridos por los puntos. Sin embargo, existen casos en donde estas funciones pueden llevar a resultados err&oacute;neos. Una alternativa es la de aplicar polinomios de orden inferior a subconjuntos de datos. Estos polinomios conectados se llaman funciones de interpolaci&oacute;n segmentaria <i>(spline functions).</i></font></p>     <p align="justify"><font face="verdana" size="2">Por ejemplo, las curvas de tercer orden empleadas para conectar cada par de datos se llaman funciones de interpolaci&oacute;n c&uacute;bica segmentaria <i>(cubic splines). </i>Estas funciones tienen la propiedad adicional de que las conexiones entre ecuaciones c&uacute;bicas adyacentes son visualmente suaves. En principio pareciera que la aproximaci&oacute;n segmentar&iacute;a de tercer orden es inferior a la expresi&oacute;n de s&eacute;ptimo orden, lo que no es as&iacute;.</font></p>    <p align="justify"><font face="verdana" size="2">Ahora bien, el objetivo de la interpolaci&oacute;n c&uacute;bica segmentaria es obtener polinomios de tercer orden para cada uno de los intervalos entre nodos de la forma:</font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e2.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Por to tanto, para los n + 1 puntos (i = 0, 1, 2,. . . , n), existen <i>n </i>intervalos y, por lo tanto, <i>4n </i>inc&oacute;gnitas constantes por evaluar. Como se hace para polinomios cuadr&aacute;ticos, en este caso se requiere de cinco condiciones para evaluar las inc&oacute;gnitas. Estas son:</font></p>    ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">1.  Los valores de la funcion deben ser iguales en los nodos interiores</font></p>    <p align="justify"><font face="verdana" size="2">2.  (2n 2 condiciones).</font></p>    <p align="justify"><font face="verdana" size="2">3.  La primera y la &uacute;ltima funci&oacute;n deben pasar a trav&eacute;s <i>de los </i>puntos finales (dos condiciones).</font></p>    <p align="justify"><font face="verdana" size="2">4.  Las primeras derivadas en los nodos interiores deben <i>ser </i>iguales (n &#45; 1 condiciones).</font></p>    <p align="justify"><font face="verdana" size="2">5.  Las segundas derivadas en los nodos interiores deben ser iguales (n &#45; 1 condiciones).</font></p>    <p align="justify"><font face="verdana" size="2">6.  Las segundas derivadas en los nodos finales son cero (dos condiciones).</font></p>    <p align="justify"><font face="verdana" size="2">La interpretaci&oacute;n visual de la condici&oacute;n 5 es que la funcion sea una l&iacute;nea recta en los nodos finales. Debido a la especificaci&oacute;n de esta condici&oacute;n es que se le llama interpolaci&oacute;n segmentaria "natural". Se le da este nombre ya que el polinomio interpolante se comporta de manera natural en este esquema. Si el valor de la segunda derivada en los nodos finales fuese diferente de cero (es decir, existe alguna curvatura), entonces esta informaci&oacute;n se usar&iacute;a alternativamente para proporcionar las dos condiciones necesarias.</font></p>    <p align="justify"><font face="verdana" size="2">Los cinco tipos anteriores de condiciones proporcionan un total de <i>4n </i>ecuaciones necesarias para encontrar los <i>4n </i>coeficientes. De esta manera es posible obtener una interpolaci&oacute;n c&uacute;bica segmentaria. Una manera pr&aacute;ctica de generar el ajuste segementario mediante un <i>spline </i>c&uacute;bico es llevando a cabo los siguientes pasos:</font></p>    <p align="justify"><font face="verdana" size="2">El primer paso en la obtenci&oacute;n se basa en la observaci&oacute;n de que debido a que cada pareja de nodos esta conectada por un polinomio c&uacute;bico, la segunda derivada dentro de cada intervalo es una l&iacute;nea recta. La ecuaci&oacute;n (1) se puede derivar dos veces para verificar esta observaci&oacute;n. Con base a lo anterior, las segundas derivadas se representan mediante los polinomios de interpolacion de primer orden de Lagrange:</font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e1.jpg"></font></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">En donde <i><i>f"</i><sub>i</sub>(x) </i>es el valor de la segunda derivada en el primer nodo <i>x </i>dentro del iesimo intervalo. Por to tanto, esta ecuaci&oacute;n es una linea recta que conecta la segunda derivada en el primer nodo <i>f"</i>(x <sub>i-l</sub>) con la segunda derivada en el segundo nodo<i>f"</i>(x<sub>i</sub> ).</font></p>     <p align="justify"><font face="verdana" size="2">Como segundo paso, la ecuaci&oacute;n (2) se integra dos veces y se obtiene una expresi&oacute;n <i>para f<sub>i</sub>(x). </i>Sin embargo, esta expresi&oacute;n tiene dos inc&oacute;gnitas constantes de integraci&oacute;n. Estas constantes se eval&uacute;an considerando las condiciones de equiespaciamiento <i>f(x) </i>debe ser <i>igual f(x</i><sub>i-l</sub><i>) </i>en <i>x</i><sub>i-l </sub><i>yf(x<sub>i</sub>) </i>debe ser igual <i>a f(x<sub>i</sub></i>) en <i>x<sub>i</sub></i>. Llevando a cabo estas evaluaciones, se obtiene la siguiente ecuaci&oacute;n c&uacute;bica:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e3.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Cabe destacar que esta expresi&oacute;n es mucho m&aacute;s complicada para los polinomios de interpolaci&oacute;n segmentaria en el i&#45;&eacute;simo intervalo, es decir, la ecuaci&oacute;n (1). Sin embargo, n&oacute;tese que esta contiene s&oacute;lo dos "coeficientes" inc&oacute;gnitas, las segundas derivadas al principio y al final del intervalo, <i><i>f"</i>(x</i><sub>i-l</sub><i>) y<i>f"</i>(x<sub>i</sub>)</i>. Por lo tanto, si se determina propiamente la segunda derivada en cada nodo, la ecuaci6n (3) es un polinomio de tercer orden que se usa para interpolar dentro de un intervalo.</font></p>    <p align="justify"><font face="verdana" size="2">Las segundas derivadas se eval&uacute;an usando la condici&oacute;n de que las primeras derivadas en los nodos deben ser continuas:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e4.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">La ecuaci&oacute;n (3) se deriva y se obtiene una expresi&oacute;n de la primera derivada. Si esto se hace para los <i>(i </i>+ 1)esimos a i&eacute;simos y los dos resultados se igualan, de acuerdo a la ecuaci&oacute;n (4), obtenemos la siguiente relaci&oacute;n:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e5.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Dado que la ecuaci&oacute;n (5) se escribe para todos los nodos interiores, resultan n &#45; 1 ecuaciones simult&aacute;neas con n + 1 segundas derivadas inc&oacute;gnitas. Sin embargo ya que este es un polinomio interpolante "natural", las segundas derivadas en los nodos finales son cero y el problema reduce a n &#45; 1 ecuaciones con n &#45; 1 inc&oacute;gnitas. Ademas not&eacute;se que el sistema de ecuaciones ser&aacute; tridiagonal. Por lo tanto, no s&oacute;lo se tiene que reducir el n&uacute;mero de ecuaciones sino que tambi&eacute;n se calculan de forma que sean muy f&aacute;ciles de resolver.</font></p>    <p align="justify"><font face="verdana" size="2">Finalmente, la derivaci&oacute;n genera las siguientes ecuaciones c&uacute;bicas para cada intervalo:</font></p>    ]]></body>
<body><![CDATA[<p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e6.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">La ecuaci&oacute;n contiene &uacute;nicamente dos inc&oacute;gnitas, las segundas derivadas al final de cada intervalo. Dichas inc&oacute;gnitas se eval&uacute;an usando la ecuaci&oacute;n siguiente:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e7.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Como esta ecuaci&oacute;n se escribe para todos los nodos interiores, se generan n &#45;1 inc&oacute;gnitas (segundas derivadas en los nodos finales son cero).</font></p>    <p align="justify"><font face="verdana" size="2">Cabe mencionar que las <i>splines c&uacute;bicas </i>han resultado ser las m&aacute;s adecuadas para aplicaciones como la mencionada anteriormente.</font></p>    <p align="justify"><font face="verdana" size="2">As&iacute; pues, podemos decir de manera concreta, que una funci&oacute;n <i>spline </i>est&aacute; formada por varios polinomios, cada uno definido en un intervalo y que se unen entre s&iacute; bajo ciertas condiciones de continuidad.</font></p>    <p align="justify"><font face="verdana" size="2">Para un <i>spline </i>de grado k, suponemos que <i>x<sub>0</sub> &lt; x<sub>1</sub> &lt; ... </i>x<sub>n</sub>, y dado <i>k </i>un n&uacute;mero entero positivo, una funci&oacute;n de interpolaci&oacute;n <i>spline </i>de grado <i>k, </i>para la tabla de datos, es una funci&oacute;n <i>s(x) </i>tal que:</font></p>    <p align="justify"><font face="verdana" size="2">i) s(x<sub>i</sub>) = <i>y</i><sub>i</sub><i>, </i>para toda <i>i = </i>0, 1,..., n.</font></p>     <p align="justify"><font face="verdana" size="2">ii) s(x<sub>i</sub>) es un polinomio de grado <u>&lt;</u> <i>k </i>en cada subintervalo &#91;<i>x<sub>i-1</sub>, x<sub>i</sub></i>&#93;.</font></p>    <p align="justify"><font face="verdana" size="2">iii ) s(x<sub>i</sub>) tiene derivada cont&iacute;nua hasta de orden k &#45; 1 en &#91;<i>x<sub>0</sub>, x<sub>n</sub></i>&#93;.</font></p>    ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">As&iacute;, para una funci&oacute;n <i>spline </i>de grado uno que interpole los datos es simplemente unir cada uno de los puntos mediante segmentos de recta, entonces:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e8.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">donde:</font></p>    <p align="justify"><font face="verdana" size="2">i) s<sub>j</sub> (x) es un polinomio de grado menor o igual que 1. </font></p>     <p align="justify"><font face="verdana" size="2">ii) s(x) tiene derivada continua de orden <i>k&#45;1 =0. </i></font></p>     <p align="justify"><font face="verdana" size="2">iii) s(x<sub>j</sub>) <i>= y</i><sub>j</sub><i>, </i>para <i>j</i> = 0, 1,..., n .</font></p>     <p align="justify"><font face="verdana" size="2">Por lo tanto, la <i>spline </i>de grado 1 queda definida como:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e9.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">donde <i>f</i> &#91;<i>x<sub>i</sub>, x<sub>j</sub></i>&#93; es la diferencia dividida de Newton.</font></p>    <p align="justify"><font face="verdana" size="2">El siguiente caso, que es el m&aacute;s importante en las aplicaciones, sigue exactamente los mismos pasos del ejemplo que acabamos de resolver, solamente que en vez de trabajar con polinomios cuadr&aacute;ticos, lo hace con polinomios c&uacute;bicos.</font></p>    ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">Y para una <i>spline </i>c&uacute;bica que interpola n + 1 datos, es una funci&oacute;n <i>s(x) </i>tal que:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e10.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">donde cada <i>s<sub>i</sub>(x) </i>es un polinomio c&uacute;bico; <i>s<sub>i</sub>(x) = y<sub>i</sub>, </i>para toda <i>i = </i>0, 1,..., n y tal que <i>s<sub>i</sub>(x) </i>tiene primera y segunda derivadas cont&iacute;nuas en &#91;<i>x<sub>0</sub></i>, x<sub>n</sub>&#93;.</font></p>    <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><b>Resultados obtenidos con la aplicaci&oacute;n <i>spline</i></b></font></p>     <p align="justify"><font face="verdana" size="2">Empleando los <i>splines </i>podemos desagregar las estructuras por edades de la poblaci&oacute;n que tenemos por grupos quinquenales de edades en edades individuales, con el fin de tener los denominadores de las tasas espec&iacute;ficas de mortalidad para la elaboraci&oacute;n de las tablas completas de vida.</font></p>    <p align="justify"><font face="verdana" size="2">En t&eacute;rminos pr&aacute;cticos, se desea desagregar el histograma o pir&aacute;mide de poblaci&oacute;n, de barras que representan grupos quinquenales a barras que representen edades individuales.</font></p>    <p align="justify"><font face="verdana" size="2">El algoritmo que lo permite, empleando los <i>splines, </i>se detalla a continuaci&oacute;n, comparando sus resultados con los que se obtienen con el uso de los factores que Henry Beers obtuvo con sus f&oacute;rmulas de interpolaci&oacute;n.<sup><a href="#nota">1</a></sup></font></p>    <p align="justify"><font face="verdana" size="2">Supongamos: x<sub>1</sub>&lt; x<sub>2</sub> &lt; x<sub>3</sub> &lt;...&lt; x<sub>n</sub> <sub>+</sub> <sub>1</sub>, y que <i>h<sub>i</sub> </i>es la altura de la barra correspondiente al intervalo &#91;x<sub>i</sub><i>, x<sub>1</sub> <sub>+</sub> <sub>1</sub></i><sub></sub>&#93;<i>.</i></font></p>    <p align="justify"><font face="verdana" size="2">Sea <i>h<sub>i</sub> </i>la frecuencia observada en la i&#45;&eacute;sima clase. </font></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">Entonces <i>h<sub>i</sub>(x<sub>i</sub> <sub>+</sub> <sub>1</sub> &#45; x<sub>i</sub></i>) = h<sub>i</sub> <i>&#916;x<sub>i</sub> </i>representa la frecuencia relativa fr(i) en el intervalo &#91;<i>x<sub>i</sub>, x<sub>i</sub> <sub>+</sub> <sub>1</sub></i>&#93;</font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e11.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">donde fa(i) es la frecuencia absoluta de la i&#45;&eacute;sima clase.</font></p>     <p align="justify"><font face="verdana" size="2">La funci&oacute;n de densidad permite calcular la probabilidad de que la variable tome valores en un cierto intervalo &#91;a,b&#93; y es igual a:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e12.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">y el valor esperado de x y su desviaci&oacute;n est&aacute;ndar:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e13.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">la condici&oacute;n del <i>spline </i>parab&oacute;lico <i>f</i> que suaviza el histograma es:</font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e14.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Para cada secci&oacute;n P<sub>i</sub> (x) de <i>f</i> se puede escribir v&iacute;a la f&oacute;rmula de Taylor como:</font></p>     ]]></body>
<body><![CDATA[<p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e15.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">El problema fundamental consiste en escoger los polinomios r<sub>1</sub>(x), r<sub>2</sub>(x) y r<sub>3</sub> (x) tales que:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e16.jpg"></font></p>     <p align="justify"><font face="verdana" size="2"><i>sean</i>:</font></p>     <p align="center"><font face="verdana" size="2"><i>r<sub>1</sub> (x)</i>= (<i>1&#45;y</i>) (<i>1&#45;3y)= 1&#45;</i>4<i>y</i> + <i>3y<sup>2</sup></i></font></p>     <p align="center"><font face="verdana" size="2"><i>r<sub>2</sub> (x)= y(3y&#45;2) = 3y<sup>2</sup>&#45;2y </i></font></p>     <p align="center"><font face="verdana" size="2"><i>r<sub>3</sub> (y)= 6y(1&#45;y) = 6y&#45;6y<sup>2</sup></i></font></p>     <p align="justify"><font face="verdana" size="2">N&oacute;tese que:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e17.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Y ya que en el histograma se satisface que:</font></p>     ]]></body>
<body><![CDATA[<p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e18.jpg"></font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e19.jpg"></font></p>     <p align="justify"><font face="verdana" size="2"><i>Finalmente</i>:</font></p>    <p align="center"><font face="verdana" size="2"><i>f(x) = P<sub>i</sub>(x) = f(x<sub>i</sub>)r<sub>i</sub>(y) + f(x<sub>i+1</sub>)r<sub>2</sub>(y) + h<sub>i</sub>r<sub>3</sub>(y)</i></font></p>    <p align="justify"><font face="verdana" size="2">Para garantizar la continuidad, se obtiene para x<sub>i</sub> <u>&lt;</u> x<sub>i</sub> <sub>&#45;</sub> <sub>1</sub></font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e20.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">De tal manera que la condici&oacute;n de continuidad de f': P' <i><sub>i-l</sub> </i>(x<sub>i</sub>)= P'<i><sub>i</sub></i> (x<sub>i</sub>), <i>i</i>=2,..., n, es tal que:</font></p>     <p align="center"><font face="verdana" size="2">&#916;x<sub>i</sub> <i>f</i>(<sub>i-1</sub>) + 2 (&#916;x<sub>i</sub>+&#916;x<sub>i-1</sub> <i>f</i>(x<sub>i</sub>) + &#916;x<sub>i-1</sub> <i>f</i>(x<sub>i+1</sub>)= 3&#916;x<sub>i</sub> <i>h</i><sub>i-1</sub> + &#916;x<sub>i-1</sub> <i>h</i><sub>i</sub></font></p>     <p align="justify"><font face="verdana" size="2"><i>tomando</i>:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e21.jpg"></font></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2"><i>entonces</i>:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e22.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Matricialmente:</font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e23.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">y para corregir los extremos se tiene que:</font></p>     <p align="center"><font face="verdana" size="2"><i>2 f (x<sub>1</sub>) + f (x<sub>2</sub>)= 3h<sub>i</sub> = e<sub>1</sub></i></font></p>     <p align="center"><font face="verdana" size="2">y <i>f (x<sub>n</sub>)</i></font> <font face="verdana" size="2"><i>+ 2f (x<sub>n+1</sub>)= 3h<sub>n</sub> = e<sub>n+1</sub></i></font></p>     <p align="justify"><font face="verdana" size="2">Modific&aacute;ndose el sistema matricial a:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3e24.jpg"></font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3g1.jpg"></font></p>     ]]></body>
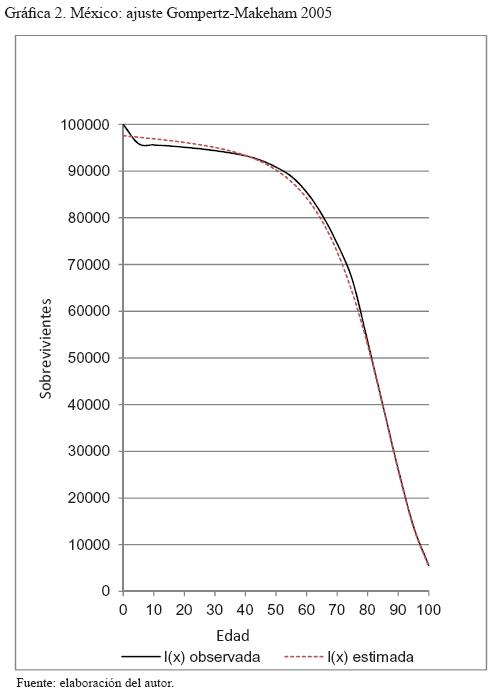
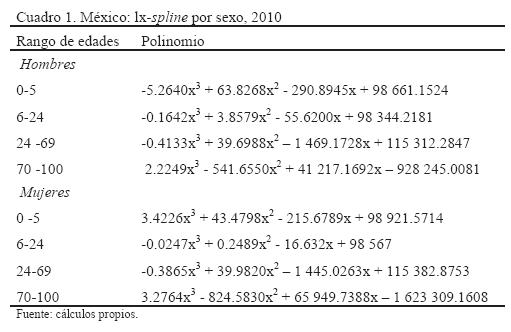
<body><![CDATA[<p align="justify"><font face="verdana" size="2">En el ajuste y proyecci&oacute;n de las funciones de supervivencia, que permiten la elaboraci&oacute;n de tablas de vida desagregadas por edad, se han empleado funciones como la Gompertz, Gompertz&#45;Makeham, y Lazarus, entre otras, las que tiene el problema del ajuste de ellas en las primeras edades, ya que la concavidad no se ajusta a dichas funciones, si bien es cierto que lo hacen para el resto de las edades.</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3g2.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Con el ajuste de interpolaci&oacute;n segmentaria <i>(spline) </i>se logra superar el problema ya que al ajustarse un polinomio de grado tres en las primeras edades la concavidad se conserva en el ajuste.</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3g3.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Una de las ventajas del ajuste <i>spline </i>es que la tendencia de las probabilidades de muerte <i><sub>n</sub>q<sub>x</sub> </i>de las tablas de vida son consistentes con las tendencias observadas, hecho que no necesariamente se da en los ajustes tipo Gompertz&#45;Makeham.</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3g4.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">El <i>spline </i>obtenido de los sobrevivientes a edad exacta (lx) por sexo, para el a&ntilde;o 2010, por nodos especificados en rango de edades es:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3c1.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">Las tablas de vida por edad individual, para hombres y mujeres a nivel nacional para el a&ntilde;o 2010, obtenida con el ajuste <i>spline </i>son:</font></p>    <p align="center"><font face="verdana" size="2"><a href="/img/revistas/pp/v17n69/html/a3c2.htm" target="_blank">Cuadro 2</a></font></p>    ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">Y las esperanzas de vida que se obtuvieron con el ajuste <i>spline&#45;lx </i>proyectando los par&aacute;metros de los polinomios por nodos, para los a&ntilde;os 2010 al 2050, por edad y sexo, tomadas de tablas de vida completas obtenidas son:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3c3a.jpg"></font></p>     <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3c3b.jpg"></font></p>     <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><b>A manera de conclusi&oacute;n</b></font></p>    <p align="justify"><font face="verdana" size="2">Las ganancias en la esperanza de vida, que se espera tendr&aacute; la poblaci&oacute;n mexicana en los pr&oacute;ximos 40 a&ntilde;os, obtenidas a partir del las tablas de vida completas obtenidas por ajuste y proyecci&oacute;n <i>spline&#45;lx, </i>para hombres y mujeres, son:</font></p>    <p align="center"><font face="verdana" size="2"><img src="/img/revistas/pp/v17n69/a3c4.jpg"></font></p>     <p align="center"><font face="verdana" size="2"><a href="/img/revistas/pp/v17n69/a3g5.jpg" target="_blank">Gr&aacute;fica 5</a></font></p>     <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><b>Bibliograf&iacute;a</b></font></p>     ]]></body>
<body><![CDATA[<!-- ref --><p align="justify"><font face="verdana" size="2">HENRICI, P., 1982, <i>Essential of numerical analysis, </i>John Wiley &amp; Sons, New York.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=5820574&pid=S1405-7425201100030000300001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --></font></p>    <!-- ref --><p align="justify"><font face="verdana" size="2">HILDEBRAND, Francis, 1987, <i>Introduction to numerical analysis, </i>McGraw&#45;Hill, Inc.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=5820576&pid=S1405-7425201100030000300002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --></font></p>    <!-- ref --><p align="justify"><font face="verdana" size="2">KINCAID, David, Ward CHENEY, 1994, <i>An&aacute;lisis num&eacute;rico. Las matem&aacute;ticas del c&aacute;lculo cient&iacute;fico, </i>Addison&#45;Wesley Iberoamericana.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=5820578&pid=S1405-7425201100030000300003&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --></font></p>    <!-- ref --><p align="justify"><font face="verdana" size="2">MINA VALD&Eacute;S, Alejandro, 2001, "Funciones de sobrevivencia, empleadas en el an&aacute;lisis demogr&aacute;fico", en revista <i>Papeles de Poblaci&oacute;n, </i>n&uacute;m. 28, abr&#45;jun, CIEAP&#45;UAEM, Toluca, M&eacute;xico.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=5820580&pid=S1405-7425201100030000300004&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --></font></p>     <!-- ref --><p align="justify"><font face="verdana" size="2">MINA VALD&Eacute;S, Alejandro, 2006, "Ley de mortalidad mexicana, funciones de supervivencia", en <i>Revista Estudios Demogr&aacute;ficos y Urbanos, </i>vol. 21, n&uacute;m. 2.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=5820582&pid=S1405-7425201100030000300005&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --></font></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><a name="nota"></a><b>Nota</b></font></p>     <p align="justify"><font face="verdana" size="2"><sup>1</sup> Ver: Beers Henry, "Six&#45;Term Formulas for Routine Actuarial Interpolation" <i>en Record of the American Institute of Actuaries, </i>vol.34, june, 1945.</font></p>     <p align="justify"><font face="verdana" size="2">&nbsp;</font></p>     <p align="justify"><font face="verdana" size="2"><b>Informaci&oacute;n sobre el autor:</b></font></p>     <p align="justify"><font face="verdana" size="2"><b>Alejandro MINA&#45;VALD&Eacute;S</b>. Actuario y Matem&aacute;tico por la Universidad Nacional Aut&oacute;noma de M&eacute;xico. Maestro en Demograf&iacute;a por El Colegio de M&eacute;xico. Profesor&#45;Investigador de tiempo completo del Centro de Estudios Demogr&aacute;ficos Urbanos y Ambientales de El Colegio de M&eacute;xico de 1979 a la fecha. Miembro del Sistema Nacional de Investigadores. Entre sus publicaciones m&aacute;s importantes destaca el cap&iacute;tulo tres, tomo uno, de la obra: <i>Los grandes problemas de M&eacute;xico, </i>editado por El Colegio de M&eacute;xico en 2010, <i>Evoluci&oacute;n de la mortalidad en M&eacute;xico: pasado, presente y futuro. </i> Correo electr&oacute;nico: <a href="mailto:amina@colmex.mx">amina@colmex.mx</a></font></p>     ]]></body><back>
<ref-list>
<ref id="B1">
<nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[HENRICI]]></surname>
<given-names><![CDATA[P.]]></given-names>
</name>
</person-group>
<source><![CDATA[Essential of numerical analysis]]></source>
<year>1982</year>
<publisher-loc><![CDATA[New York ]]></publisher-loc>
<publisher-name><![CDATA[John Wiley & Sons]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B2">
<nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[HILDEBRAND]]></surname>
<given-names><![CDATA[Francis]]></given-names>
</name>
</person-group>
<source><![CDATA[Introduction to numerical analysis]]></source>
<year>1987</year>
<publisher-name><![CDATA[McGraw-Hill, Inc.]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B3">
<nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[KINCAID]]></surname>
<given-names><![CDATA[David]]></given-names>
</name>
<name>
<surname><![CDATA[CHENEY]]></surname>
<given-names><![CDATA[Ward]]></given-names>
</name>
</person-group>
<source><![CDATA[Análisis numérico. Las matemáticas del cálculo científico]]></source>
<year>1994</year>
<publisher-name><![CDATA[Addison-Wesley Iberoamericana]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B4">
<nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[MINA VALDÉS]]></surname>
<given-names><![CDATA[Alejandro]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Funciones de sobrevivencia, empleadas en el análisis demográfico]]></article-title>
<source><![CDATA[Papeles de Población]]></source>
<year>2001</year>
<numero>28</numero>
<issue>28</issue>
<publisher-loc><![CDATA[Toluca ]]></publisher-loc>
<publisher-name><![CDATA[CIEAP-UAEM]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B5">
<nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[MINA VALDÉS]]></surname>
<given-names><![CDATA[Alejandro]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Ley de mortalidad mexicana, funciones de supervivencia]]></article-title>
<source><![CDATA[Revista Estudios Demográficos y Urbanos]]></source>
<year>2006</year>
<volume>21</volume>
<numero>2</numero>
<issue>2</issue>
</nlm-citation>
</ref>
</ref-list>
</back>
</article>